Beaucoup de DSI ont acheté leurs premiers serveurs GPU projet par projet. Un serveur pour le chatbot interne, deux pour l’équipe data, un pour un test de fine-tuning. Chaque serveur appartient à une équipe. Quand cette équipe ne s’en sert pas, le GPU reste inutilisé, et les autres équipes demandent leur propre serveur.
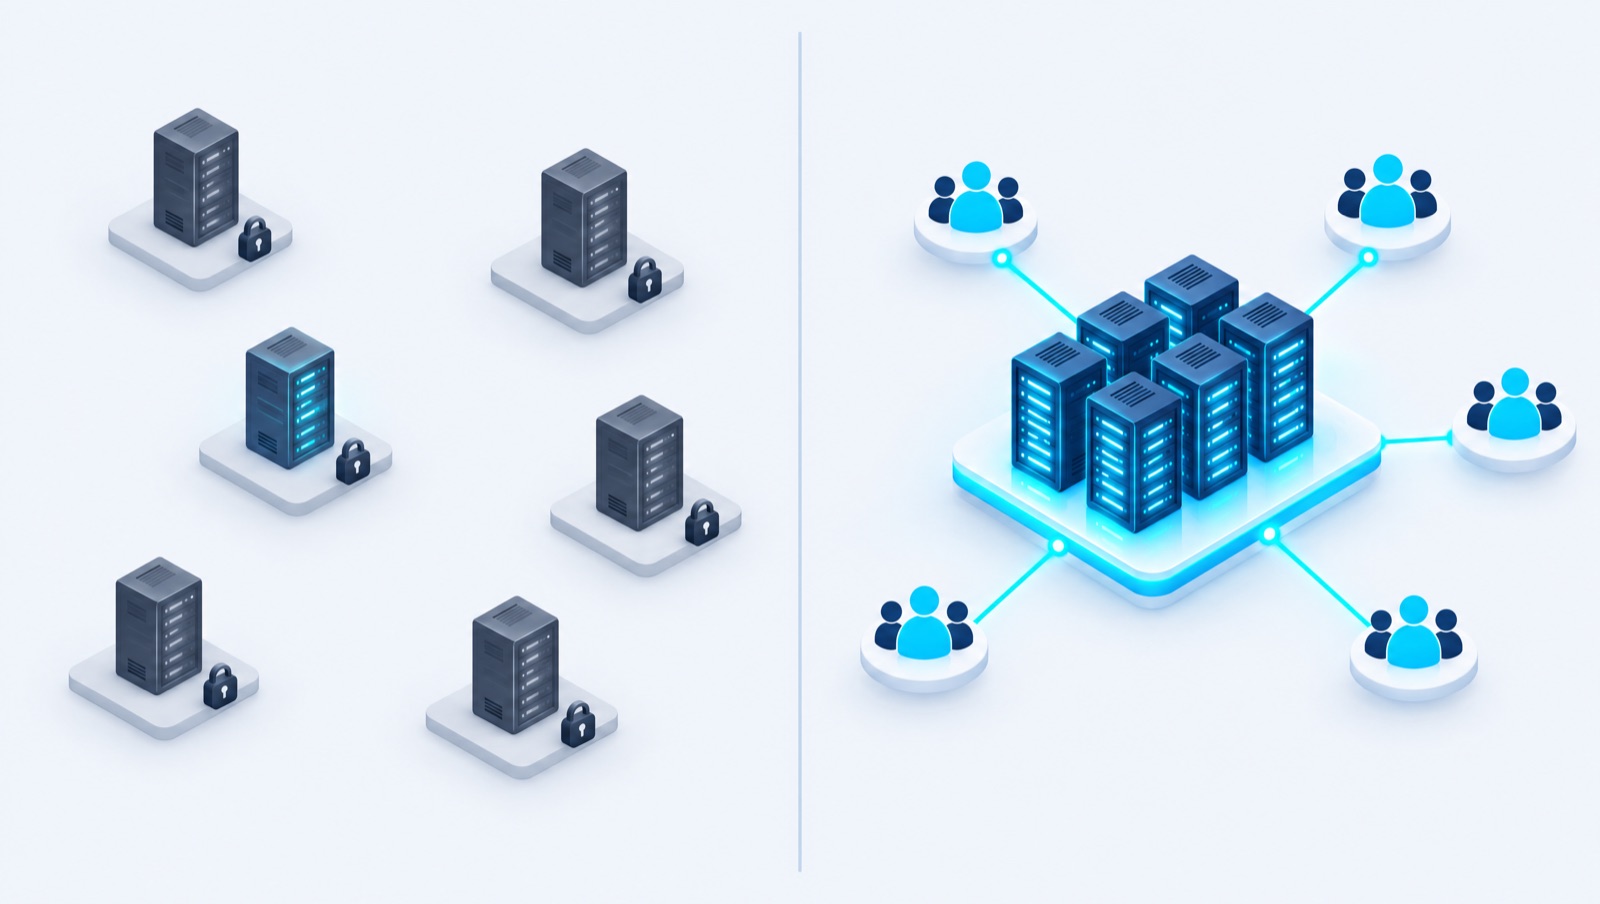
Une AI Factory règle ce problème. C’est une seule infrastructure, partagée entre toutes les équipes, qui fournit des GPU à la demande pour trois usages : le développement, l’entraînement et l’inférence.
Cet article part d’un exemple : une DSI qui dispose de 7 serveurs GPU. Il décrit les 6 étapes pour en faire une AI Factory, avec la pile open source que Cloud Inspire déploie : OpenNebula, KVM, Kubernetes, Slurm et vLLM. La méthode est la même avec 3 serveurs ou avec 20 : seule la répartition change.
Étape 1 — Partir des usages, pas des serveurs
Avant de configurer quoi que ce soit, listez qui a besoin de GPU et pour quoi faire. Dans la plupart des organisations, on retrouve trois familles d’usages :
| Usage | Qui | Besoin type |
|---|---|---|
| Développement | Data scientists, développeurs | Un notebook ou une VM avec un GPU, disponible en quelques minutes |
| Entraînement et fine-tuning | Équipe data, R&D | Plusieurs GPU pendant quelques heures ou quelques jours, puis rien |
| Inférence | Applications métier, chatbots, RAG | Des modèles (LLM) servis en continu, avec une disponibilité de production |
Ces trois usages n’ont pas le même profil. L’inférence tourne en permanence. L’entraînement arrive par pics. Le développement est irrégulier. C’est justement pour cela qu’il est rentable de les faire tourner sur les mêmes serveurs.
Pour chaque usage, notez aussi les contraintes : données sensibles, modèles à héberger, nombre d’utilisateurs, heures de pointe.
Étape 2 — Répartir les 7 serveurs selon les usages
Avec les usages listés, vous pouvez répartir les serveurs. Voici un exemple de départ pour 7 serveurs :
| Pool | Serveurs | Usage | Outil |
|---|---|---|---|
| Inférence | 3 | LLM servis aux applications | Kubernetes + vLLM |
| Entraînement | 2 | Fine-tuning et entraînement | Slurm |
| Développement | 2 | VM et notebooks avec GPU | VM OpenNebula |
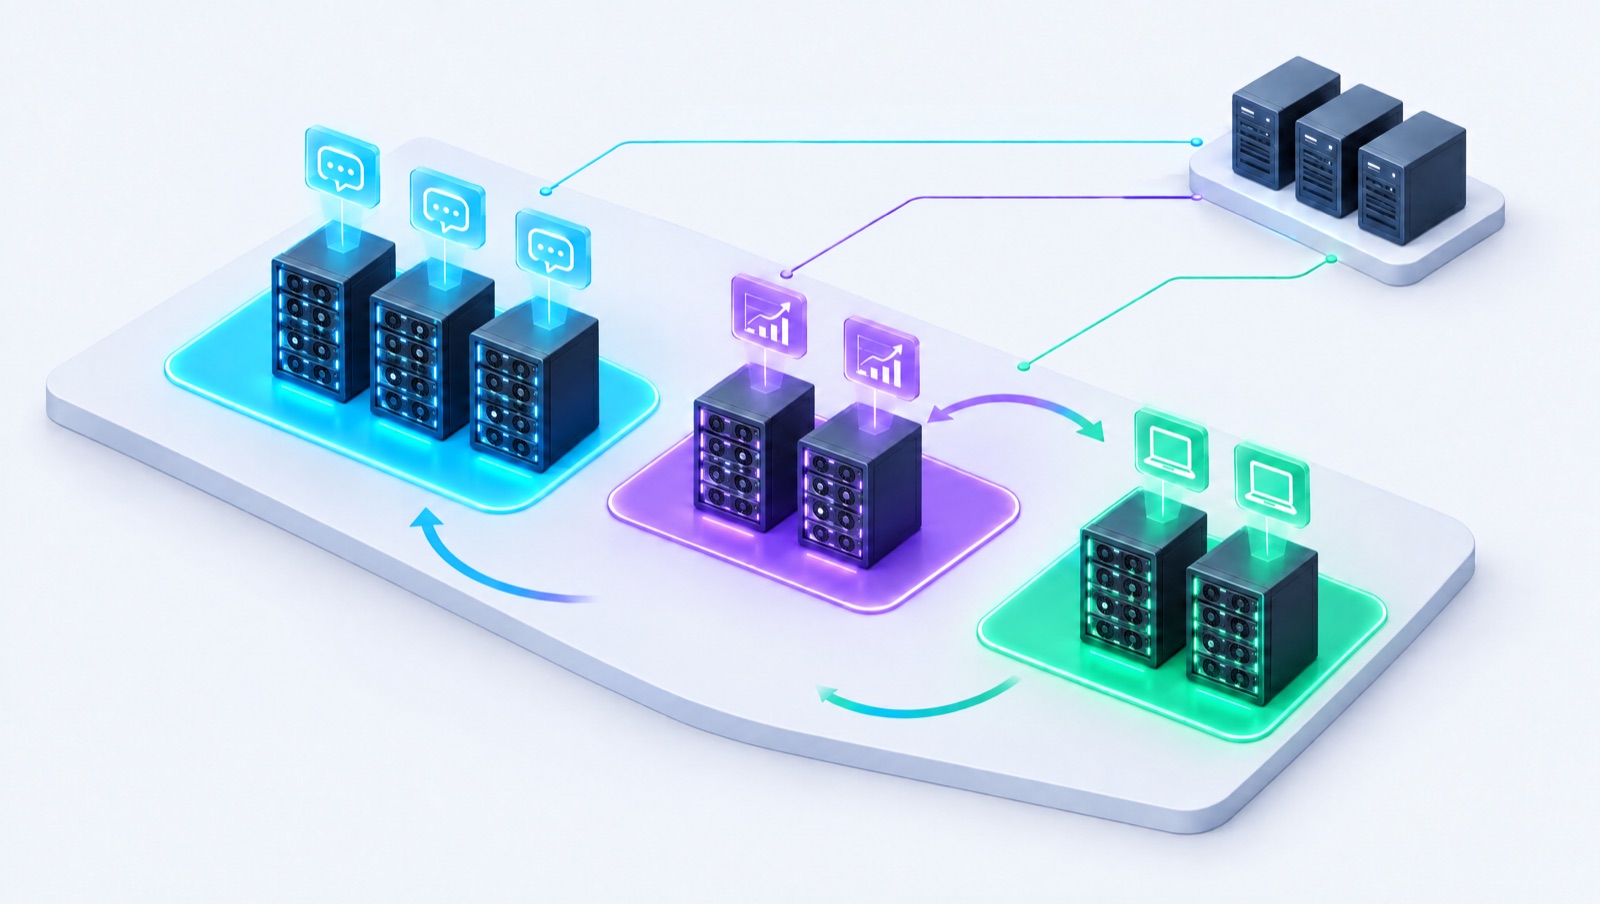
Le plan de contrôle (OpenNebula, Kubernetes, Slurm) ne doit pas tourner sur les serveurs GPU. Il s’installe sur trois petits serveurs ou trois VM sans GPU, pour la haute disponibilité.
Cette répartition n’est pas figée. Avec OpenNebula, un serveur peut passer d’un pool à l’autre quand les besoins changent. Par exemple, un serveur d’entraînement peut rejoindre le pool d’inférence pendant le lancement d’un nouveau service, puis revenir à l’entraînement.
Étape 3 — Choisir comment partager chaque GPU
Il existe trois façons de donner un GPU à une charge de travail. Le bon choix dépend de l’usage et du modèle de GPU.
| Mode | Principe | Quand l’utiliser | Ce qu’il faut savoir |
|---|---|---|---|
| PCI passthrough | Un GPU entier est attribué à une VM | Entraînement, inférence de gros modèles | Performance maximale, pas de partage |
| MIG (Multi-Instance GPU) | Un GPU est découpé en instances isolées, jusqu’à 7 | Inférence de petits modèles, développement | Disponible sur les GPU de centre de données comme les A100, H100, H200 et B200. Pas sur les L40S ni les L4 |
| vGPU | Un GPU est partagé entre plusieurs VM | Postes de développement, notebooks | Nécessite une licence logicielle NVIDIA vGPU |
Dans notre exemple, les serveurs d’entraînement utilisent le passthrough. Les serveurs de développement utilisent MIG ou vGPU selon le modèle de carte. Le pool d’inférence combine les deux : des GPU entiers pour les gros modèles, des instances MIG pour les petits.
Un point de dimensionnement : la taille d’un modèle détermine la mémoire GPU nécessaire. Un modèle de 70 milliards de paramètres en précision FP16 occupe environ 140 Go de mémoire pour ses seuls poids. Il ne tient pas sur un seul GPU de 80 Go. Il faut soit plusieurs GPU, soit une version quantifiée du modèle.
Étape 4 — Construire le socle : réseau et stockage
C’est l’étape la plus souvent sous-estimée. Des GPU rapides sur un réseau ou un stockage lent restent sous-utilisés.
Le stockage. Les modèles et les jeux de données doivent être accessibles depuis tous les serveurs, sans les copier à chaque fois. Prévoyez un stockage partagé, par exemple Ceph (intégré nativement à OpenNebula) ou un NFS performant. Les poids d’un LLM pèsent souvent plusieurs dizaines de gigaoctets : le temps de chargement d’un modèle dépend directement de ce stockage.
Le réseau. Deux réseaux sont à distinguer :
- le réseau de service, qui relie les applications aux modèles et les utilisateurs à leurs VM ;
- le réseau GPU, qui relie les serveurs entre eux quand un entraînement utilise les GPU de plusieurs serveurs à la fois. Ce réseau doit être à faible latence et à haut débit, en RoCE ou en InfiniBand.
Si vos entraînements tiennent sur un seul serveur, le réseau GPU peut attendre. Si vous prévoyez d’entraîner sur plusieurs serveurs, il faut le dimensionner dès le départ.
Étape 5 — Donner aux équipes un accès en self-service, avec des quotas
Une AI Factory n’est utile que si les équipes s’en servent sans ouvrir un ticket pour chaque demande. OpenNebula fournit pour cela :
- des groupes et des quotas : chaque équipe ou filiale dispose d’un nombre de GPU, de vCPU, de mémoire et de stockage qu’elle ne peut pas dépasser ;
- un catalogue de services : une VM avec GPU et notebook, un cluster Kubernetes, un accès au cluster Slurm, chacun créé en quelques clics ou par API ;
- l’isolation : les équipes ne voient pas les ressources des autres ;
- le suivi de consommation (showback) : la consommation de chaque équipe est mesurée, ce qui permet de la refacturer en interne ou de justifier l’investissement.
Les clusters Kubernetes sont créés à la demande par OpenNebula. Le NVIDIA GPU Operator y installe les pilotes et rend les GPU disponibles aux conteneurs. Les modèles sont servis par vLLM, ou par NVIDIA NIM si vous disposez de la licence NVIDIA AI Enterprise.
Étape 6 — Exploiter : mesurer, mettre à jour, prouver l’usage
Une fois en service, l’AI Factory doit être exploitée comme toute infrastructure de production.
- Mesurer l’usage des GPU. Le DCGM Exporter de NVIDIA remonte l’utilisation, la mémoire, la température et les erreurs de chaque GPU dans Prometheus. Grafana affiche ces données par serveur, par pool et par équipe. Ce sont ces chiffres qui montrent si l’investissement est rentabilisé.
- Mettre à jour sans interruption. Pilotes NVIDIA, versions de CUDA, versions de vLLM et modèles évoluent souvent. Les mises à jour se font serveur par serveur, en déplaçant les charges de travail.
- Gérer les modèles. Tenez un registre des modèles servis : version, origine, licence, équipe responsable.
- Automatiser. Les procédures courantes (redémarrer un modèle, ajouter un serveur à un pool, créer un environnement) doivent être écrites et exécutables, pas seulement documentées.
Une pile validée par NVIDIA
Le 29 septembre 2026, OpenNebula a obtenu la validation NVIDIA AI Cloud Ready. NVIDIA a validé une plateforme qui associe OpenNebula à des composants NVIDIA sur des systèmes GB200 NVL72. Cette validation couvre les usages décrits dans cet article : environnements multi-tenant, VM avec GPU, Kubernetes à la demande, Slurm pour le calcul distribué et inférence de LLM. (Lire l’annonce d’OpenNebula)
La validation porte sur la plateforme OpenNebula. Elle montre que la pile open source utilisée par la Cloud Factory et l’AI Factory de Cloud Inspire fonctionne sur le matériel NVIDIA le plus récent. La même pile s’applique à un cluster de 7 serveurs.
Ce que cela change pour une DSI
Avec cette approche, vos 7 serveurs ne sont plus 7 projets séparés. Ils forment une seule infrastructure :
- les GPU sont partagés entre les équipes au lieu de rester inutilisés ;
- chaque équipe obtient ses ressources en self-service, dans la limite de ses quotas ;
- la consommation est mesurée et peut être refacturée ;
- les données et les modèles restent sur votre site, ou chez un hébergeur souverain de votre choix ;
- toute la pile est open source : pas de dépendance à un hyperscaler ni à un éditeur unique pour l’orchestration.
Passer à l’action
Cloud Inspire conçoit, déploie et exploite des AI Factory sur OpenNebula, en France et en Afrique francophone. Pour en savoir plus, consultez la page AI Factory.
Vous avez déjà des serveurs GPU, ou vous préparez un achat ? Réservez 30 minutes avec un architecte pour définir la répartition et le plan de déploiement adaptés à vos usages.